〜納品前チェックツールを作って、誤検知172件と戦った記録〜
タスク管理ツール、会計システムに続いて、また社内ツールを作りました。今回はWebサイトの納品検品ツールです。
サイトのURLを渡すと、リンク切れ・画像の抜け・SEOの不備・レイアウト崩れをまとめて検査してCSVで返してくれる。そういうものを作りました。
ただ、この記事の大半は「作った話」ではなく「間違いだらけの検査結果を、どうやってまともにしたか」の話です。正直、機能を作るより誤検知を潰すほうが何倍も大変でした。
なぜ作ったか:検品は属人的になりやすい
Web制作の納品前には、必ずチェック作業があります。
- リンクが切れていないか
- 画像が表示されているか
- titleやmeta descriptionが入っているか
- スマホで見たときに崩れていないか
これを目視でやっているわけですが、正直なところ「誰がやるか」で結果が変わります。慣れている人は見るポイントを知っているし、疲れている日は見落とす。ページ数が多いサイトだと、そもそも全ページ見るのが現実的ではありません。
実際、今回テストに使ったあるサイトは1,482ページありました。人力で全ページのリンクを確認するのは無理です。
だから作りたかったのは「速くする道具」ではなく、「誰がやっても検品結果が落ちない状態」でした。時間短縮はその副産物、くらいの位置づけです。
設計で最初に決めたこと:クロールは1回、チェックは複数
技術的な話で恐縮ですが、ここが一番大事な判断でした。
検査項目は「リンク切れ」「画像」「SEO」「誤植」と複数あります。素直に作ると、チェックごとにスクリプトを分けたくなります。でもそうすると、チェックの数だけサイトを巡回することになります。
悪い例:
  リンクチェック  → サイト全体を巡回
  画像チェック    → サイト全体を巡回
  SEOチェック     → サイト全体を巡回
  → 3倍アクセスする
クライアントのサーバーに3倍の負荷をかけることになりますし、時間も3倍かかります。
なので巡回は1回だけ、取得したページを全チェックが共有する構造にしました。
良い例:
  1回だけ巡回 → 取得済みページを保持
                 ├→ リンクチェック
                 ├→ 画像チェック
                 └→ SEOチェック
地味ですが、この判断がなければ後から直すのは大変だったと思います。「最初に決めておくべきこと」の典型でした。
なお、レイアウト崩れの検知だけは別経路です。HTMLを取得しただけでは「スマホで横スクロールが出る」は分かりません。こちらはPlaywrightという道具で実際にブラウザで描画して測っています。
開発秘話1:「ドライバー」の「ライバ」
さて本題です。
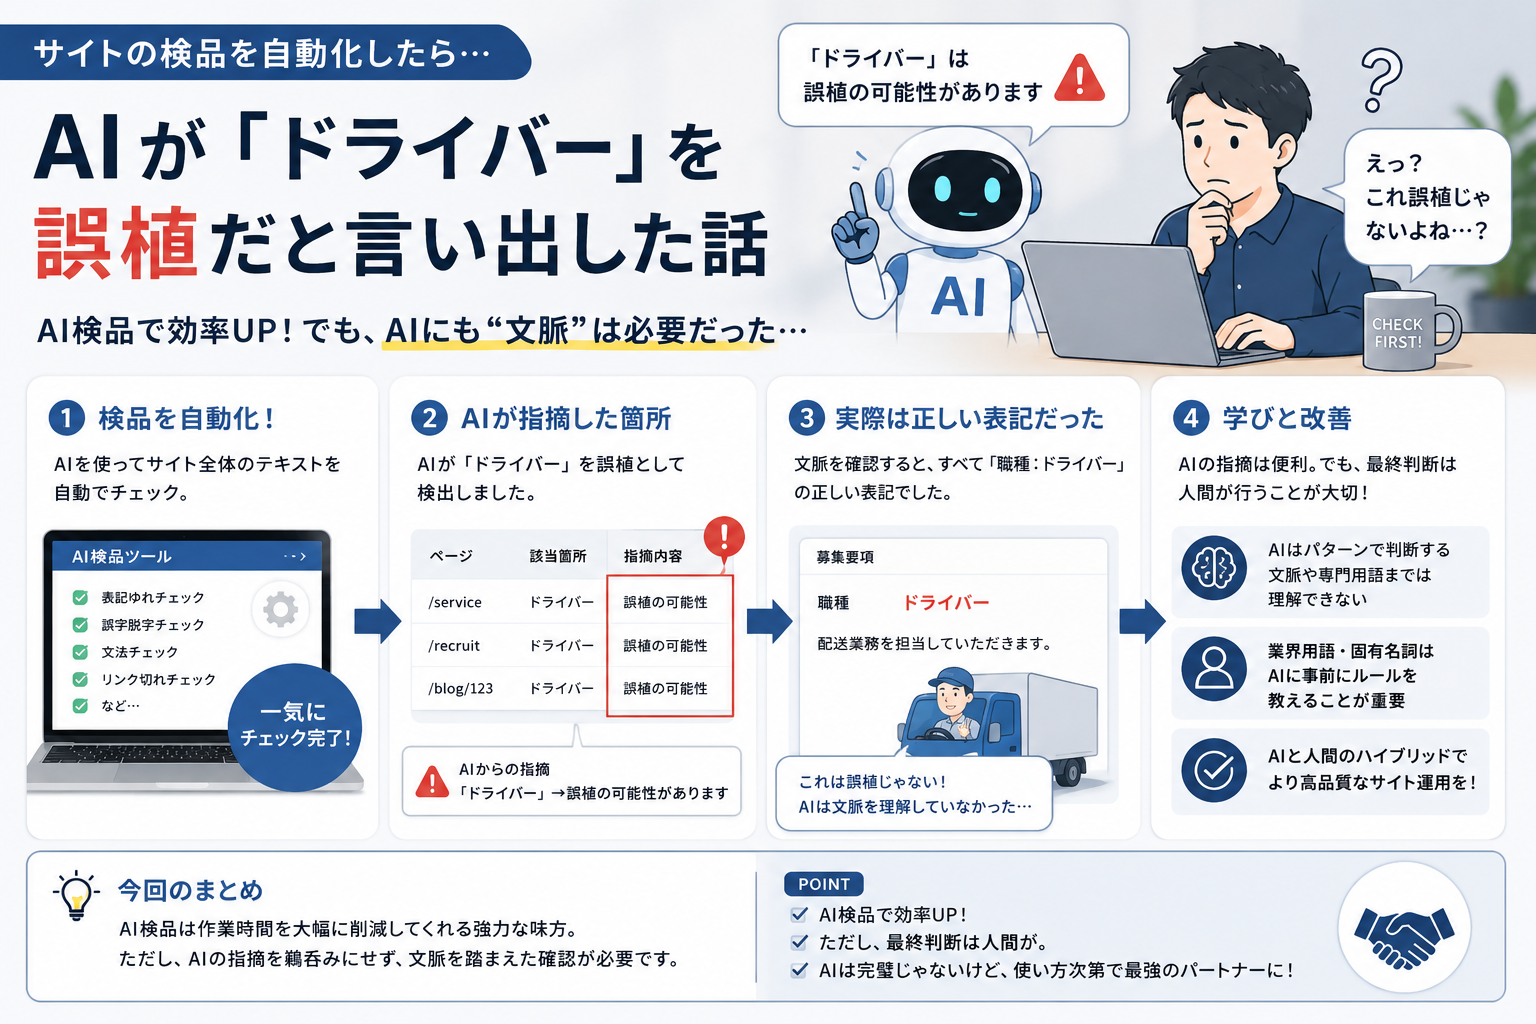
誤植検知の機能を作って、交通系の会社の採用サイトに当ててみました。出てきたレポートを見ていて、ある行で手が止まりました。
誤植  確信度:高
ライバ(279件) ↔ ライブ(3件)
「ライバ」?
よく見ると、「ドライバー」の中の「ライバ」を切り出して、「ライブ」と1文字違いだから誤植候補だと言っていたのです。ちなみに「ライブ」のほうは「ドライブレコーダー」から切り出したものでした。
どちらも正しい日本語です。完全な誤検知です。
原因を調べると、仕組みはこうでした。日本語には英語のようなスペースがないので、文章を機械的に細切れ(n-gram)にして比較しています。そのときカタカナ語の途中で切ってしまっていたわけです。
さらに厄介だったのが、断片を捨てる仕組みはあったのに、すり抜けていたことです。
「ライバ」の直前の文字:ド(9回)、プ(4回)  → 2種類
「ライバ」の直後の文字:ー(9回)、シ(4回)  → 2種類
「ドライバー」と「プライバシー」の2語にまたがって出現していたため、「前後がいつも同じなら断片」という条件に引っかからなかったのです。
修正は「同じ文字種の連続を途中で切らない」というルールでした。日本語は文字種の切れ目がだいたい語の切れ目になるので、形態素解析なしでもそれなりに近似できます。
同じ問題は漢字とひらがなでも起きていました。
| 誤検知 | 実際は |
|---|---|
| ◯バス ↔ △バス | ◯◯バス と △△バス |
| を支え ↔ を伝え | を支える と を伝える |
これで誤植候補が 605件 → 157件まで減りました。
開発秘話2:誤検知を潰したら、本物まで消えかけた
調子に乗って誤検知を潰していったら、危ないことが起きました。
観光施設のサイトを検査したとき、旧ロジックが出していた66件の中に本物が1件だけ混じっていたのです。
月1日(10件) ↔ 月1日(5件) ← 全角と半角の数字が混在これは実際の表記揺れです。イベント告知の日付が全角と半角で混ざっていました。ところが私が「送り仮名の判定を厳しくする」修正を入れた結果、この本物が落ちる寸前でした。長さが変わらないので、送り仮名の条件から外れてしまうのです。
慌てて「全角/半角の混在」を独立したカテゴリとして検出するように追加しました。
そしてこれが後で効きます。別のケーブルテレビ局のサイトを検査したとき、こんな指摘が出ました。
例)honoka(279件) ↔ honoka(20件) 全角/半角社名の表記が279箇所中20箇所で全角になっていたのです。実際にページタイトルにも全角で出ていました。目視ではまず気づけません。
観光施設のサイトで本物を削っていたら、この発見はありませんでした。
誤検知を減らす作業は、本物まで一緒に削っていないかを毎回確認しないと危ない。 これは今回一番身にしみた教訓です。
開発秘話3:規模が変わると精度が壊れる(一番深かった話)
ここからが本番です。
小規模サイトで誤検知を潰し込んで、「確信度:高」は6件まで絞れました。いい感じです。そこで1,482ページの大規模サイトに当ててみたら、こうなりました。
| ページ数 | 確信度「高」 |
|---|---|
| 100 | 12件 |
| 250 | 37件 |
| 500 | 87件 |
| 1,482 | 172件(全部誤検知) |
ページ数にほぼ比例して増えていました。
しかも中身がひどい。
お便り(3022件) ↔ お飾り(3件)
月曜日(457件)  ↔ 金曜日(25件)
母さん(278件)  ↔ 父さん(17件)
今日は(161件)  ↔ 明日は(4件)
全部、別の正しい言葉です。
なぜこうなるのか。判定は「出現数が偏っている」「文脈が似ている」「差分が漢字」といった条件の合わせ技だったのですが、文章量が増えると全部の条件が無条件に成立してしまうのです。よくある語とまれな語が1文字違いなら、なんでも「高」になる。
最初は閾値の調整で直そうとしました。でも、途中で気づきました。
「月曜日」と「金曜日」は、定義上まったく同じ文脈に現れます。 「母さん」と「父さん」も、「今日は」と「明日は」もそうです。同じ位置に入る別の語だからです。そして本物の誤植も、やはり同じ文脈に現れます。
つまり文脈では原理的に区別できない。区別するには「その語が実在するか」を知る必要があって、それには辞書が要る。持っていない。
閾値をいじる方向では、どうやっても解決しない問題でした。
そこで発想を変えて、判定の性質そのもので分けました。
| 検出方法 | 性質 | 確信度 |
|---|---|---|
| ホモグリフ・異体字・長音符 | 文字が客観的に間違っている | 高 |
| 全角/半角・漢数字/算用数字 | 表記の不統一(事実として確認できる) | 表記揺れ |
| 編集距離の総当たり | 似ているだけ。辞書なしでは判定不能 | 中・低が上限 |
「似ている」という理由だけで「高」を名乗らせるのをやめました。編集距離の候補は消さず、人が掘るためのリストとして中・低に残してあります。
結果はこうなりました。
| ページ数 | 変更前 | 変更後 |
|---|---|---|
| 100 | 12件 | 1件 |
| 250 | 37件 | 1件 |
| 500 | 87件 | 1件 |
規模を5倍にしても件数が変わらない。 そして残った1件が本物でした。
マタニティー(37件) ↔ マタニティ-(1件)長音符「ー」が、全角ハイフン「-」になっていました。並べて見ても違いが分からないレベルです。これが87件のノイズに埋もれていました。
「確信度:高」というラベルは、実際にそれを担保できる検出方法にだけ与える。当たり前のようですが、ここに気づくまでだいぶ遠回りしました。
開発秘話4:16,309行のレポートは、出していないのと同じ
大規模サイトの検査が通るようになって、出力されたCSVを開いたら16,309行・7.3MBありました。
誰も読みません。
中身を見ると、同じ指摘が延々と繰り返されていました。
/未分類 が404          → 1,050行(全部同じURL)
og:image が未設定 → 1,497行(全部同じ原因)「1件の指摘」を「参照元ページの数」だけ行に展開していたのが原因でした。「og:imageが1,497ページで未設定」は、1行で済む指摘です。
そこで「1件の指摘 = 1行」に変えて、該当ページは件数と例に畳みました。ページごとに文字列が変わる指摘(titleが長い(54文字): 実際のタイトル)は、原因(titleが長い)と詳細を分離して原因単位でまとめました。
結果、SEOの指摘は 9,519行 → 11行になりました。
そして11行になった瞬間、埋もれていたものが見えました。
[エラー] noindex     152ページ  ← 検索結果に出ない設定
[注意]  canonical   353ページ  ← 自ページと異なる
noindexはエラーレベルの指摘です。 9,519行の中に埋もれていて、誰も気づけない状態でした。集約して初めて浮かび上がってきました。
「誤検知だらけのリストは読まれない」とはよく言いますが、読めない量のレポートも、出していないのと同じでした。
開発秘話5:同じ種類のミスを、1日に3回踏んだ
これは自分への戒めとして書いておきます。
1日の作業で、まったく同じ構造のミスを3回やりました。
| やらかし | 内容 |
|---|---|
| 1回目 | 判定の関数を直したのに、実際の処理は別の経路を通っていた |
| 2回目 | CSVを13列に増やしたのに、サマリー行だけ10列のままだった |
| 3回目 | 集計をCSVに入れて、コンソール表示を直し忘れた |
どれも「同じことをする場所が2箇所以上あって、片方だけ直した」という同じ形です。
1回目が特に危なかった。関数の単体テストは通るのに、実行結果が589件のまま1つも変わらない。「テストは通ってるのになぜ?」としばらく悩みました。処理が別ルートを通っていたのです。
対策としてテストを足すだけでなく、処理を1箇所に集約して両方から呼ぶ形に直しました。片方だけ直すことが構造的にできなくなります。
あわせて「コンソールとCSVで件数が一致すること」を検証するテストも置きました。次に同じことをやったら、テストが落ちて気づけます。
設置編:エックスサーバーで動くのか問題
ツールができたので、スタッフが使えるようにサーバーへ置くことにしました。
社内サイト用に借りているエックスサーバーで動けば追加費用ゼロです。ただ共有レンタルサーバーなので、動くかどうかは半信半疑でした。
まず調べたところ、用意されているPythonは2.7 / 3.4 / 3.6。このツールは3.13前提なので、そのままでは動きません。
「ならMinicondaを入れよう」と実行したら、こう言われました。
Installer requires GLIBC >=2.28, but system has 2.17.サーバーのシステムライブラリがCentOS 7世代で古く、現行のMinicondaが要求するバージョンに届いていませんでした。
代わりに使ったのがpython-build-standaloneという、自己完結型のPythonビルドです。tarballを展開するだけで動きます。
~/python313/ ← ここに展開しただけroot権限も不要、.bashrcも変更なし、要らなくなったらフォルダごと削除すれば消えます。Macと同じ Python 3.13.15 + OpenSSL 3.5.8 が手に入りました。依存ライブラリもMacと同一バージョンで揃えています。環境が違うと結果が変わってしまうので、ここは揃えておきたいところでした。
テスト150件がサーバー上でも全部通り、無事に動きました。
ただしレイアウト崩れの検査だけは動きません。 ブラウザ(Chromium)が必要なのですが、依存ライブラリが5件とも入っておらず、root権限がないと追加できないためです。ここは諦めて、必要になったらVPSを検討することにしました。
ちなみに「共有サーバーだからCPUやメモリで止められるだろう」と予想していたのですが、実測してみるとシェル上の制限は無制限でした。思い込みで判断せず、実際に測ってよかった例です。
UIをつける:DBは使わない判断
SSHでコマンドを打つ形だと、リモートで働くメンバーには敷居が高い。そこで簡単な画面をつけました。
URLを入力 → 実行
一覧(実行中/完了/失敗)→ CSVダウンロード
完了したらメールで通知ここで一つ判断したのが、データベースを使わないことでした。
会計システムやタスク管理ではMySQLを使っていますが、今回は見送りました。理由は、結果がすでにファイルで完結しているからです。
reports/*.csv         検品結果
jobs/<id>.json        ジョブ1件の状態
案件ごとに数回動かすだけのツールで、同時実行もほとんどありません。DBを入れると接続設定・バックアップ・障害対応が増えるだけで、見合わないと判断しました。将来サイトを横断して集計したくなったら、SQLite(ファイル1つで完結)で足ります。
技術的にできることと、入れるべきかは別という判断でした。
85分かかる処理をWebから起動する
このツールは、大きいサイトだと85分かかります。Webリクエストの中で実行したら確実にタイムアウトします。
なので「フォームは実行を受け付けるだけ、処理は別プロセスに投げる」構成にしました。エックスサーバーでこれができるか実験したところ、意外な結果に。
exec('nohup ... &');    // ✗ 失敗
exec('setsid ... &');   // ✗ 失敗
exec('bash -c "(重い処理) >/dev/null 2>&1 &"');  // ✓ これだけ動いた
一般的によく使われるnohupとsetsidが失敗し、サブシェルをバックグラウンド化する形だけが通りました。220秒走るプロセスで検証して、リクエスト終了後も生き残ることを確認しています。
メールが静かに失敗していた話
完了通知メールの実装で、地味にハマりました。エラーも出ないのにメールが届かない。
原因はPHPのワンライナー実行で、コードの先頭に<?phpを付けていたことでした。
// ✗ 開始タグを付けるとパースエラーになるが、何も出力せず静かに失敗する
php -r '<?php mb_send_mail(...);'

// ✓ 正しい
php -r 'mb_send_mail(...);'
「送ったつもりで届いていない」のが一番まずいので、修正とあわせて送信の成功・失敗を必ずログに残すようにしました。
二重実行の防止
テストを繰り返していると、同じサイトに同時アクセスしてしまう可能性に気づきました。クライアントのサーバーに対しては避けたい挙動です。
画面側で「実行中なら受け付けない」チェックを入れつつ、本当の砦としてホスト単位のロックを実装しました。異常終了でロックが残ったままにならないよう、中のプロセスがもう生きていなければ回収する仕組みも入れています(ここを忘れると、そのサイトが二度と検査できなくなります)。
数字で振り返る
精度の改善
| 項目 | 修正前 | 修正後 |
|---|---|---|
| 誤植「高」 | 172件(全部誤検知) | 1件(本物) |
| 表記揺れ | 589件(全部ノイズ) | 本物のみ |
| レイアウト崩れ | 153件 | 0〜3件 |
| CSVの行数 | 16,309行 | 13行 |
実測値(1,482ページのサイト)
- 所要時間:85分
- ピークメモリ:1.04GB
- 検証した実サイト:5種類(コーポレート/飲食/採用/観光施設/ケーブルテレビ)
- 回帰テスト:150件
実際に見つかった本物の指摘
- 社名の表記が279箇所中20箇所で全角になっていた
- 長音符が全角ハイフンになっていた(目視ではまず気づけない)
- WordPressの既定カテゴリーページが404で、1,050ページからリンクされていた
- noindexが152ページに設定されていた
- canonicalが353ページで自ページと違っていた
最後の2つは、レポートを集約するまで9,519行の中に埋もれていました。
やってみてわかったこと
1. 誤検知は、見逃しと同じくらい害がある
最初にあるサイトへ当てたとき、レイアウト崩れの指摘が153件出ました。そのうち136件が同じ誤検知(ホバーで文字がスライドする演出)でした。
こういうリストは読まれなくなります。読まれないレポートは、出していないのと同じです。「たくさん検出できる」ことに価値はなくて、「読める量で、外れが少ない」ことに価値があると痛感しました。
2. 小規模で調整した設定は、大規模で通用しない
これが一番の学びでした。100ページで完璧に見えた調整が、1,482ページでは完全に破綻していました。しかも「閾値を少し変える」では直らない種類の破綻でした。
新しい判定を追加するときは、「規模が10倍になっても件数が増えないか」を必ず確認する。今はそれをルールとして書き残しています。
3. 「できない」を認めるのも設計
誤植の判定は、辞書がなければ原理的に限界があります。そこを認めた上で「確信度が高いと言えるものだけを高にする」と割り切ったことで、初めて使えるものになりました。
無理に全部を高精度にしようとしていたら、まだ迷走していたと思います。
4. 思い込みで判断せず、測る
エックスサーバーの件がまさにそうでした。「共有サーバーだから重い処理は無理だろう」と推測していましたが、実際に測ったら制限は緩く、Pythonのバージョンとブラウザの依存関係だけが問題でした。
推測で「できません」と言わずに、10分かけて調べたほうが早い。
5. AIに任せても、判断は人間に残る
これは前回の会計システムのときと同じ結論です。
コードを書くのはAIでも、「この172件は全部誤検知だ」と気づくのは人間でした。というより、そもそも最初の「ライバ」の誤検知に気づいたのは、レポートを眺めていて「これ、ドライバーの一部じゃない?」と思ったからです。
出てきた結果を鵜呑みにせず、おかしいと思ったら掘る。この作業だけは代われないと感じました。
おわりに
「サイトの検品を自動化する」と一言で言っても、実際にやってみると8割は誤検知との戦いでした。
機能を作るのは早いんです。難しいのは「その結果を信じていいか」を担保するところで、そこには自分たちの業務理解が必要でした。何が本物の指摘で、何がただの言葉の揺れなのか。それを判断できるのは、実際に検品をやっている人間だけです。
まだレイアウト崩れの検査はサーバーで動かせていませんし、施設ごとにサブドメインが分かれているサイトをまとめて検査する仕組みも作れていません。このあたりは、実際に案件で使いながら詰めていく予定です。
タスク管理ツールや会計システムの開発話も同じ視点で書いているので、よければそちらも読んでみてください。
追記:使い始めてから見つかった、もう一つの「ライバ」
ここまで書いて「完成」のつもりでした。が、実際に画面から動かして観光施設のサイトを検査し、出てきたCSVを眺めていて手が止まりました。
誤植  確信度:中
岡山城(1498件) ↔ 岡山お(5件)
また出た、と思いました。「岡山おもてなし武将隊」の途中で切っていたのです。冒頭の「ライバ」とまったく同じ構図です。
さらに眺めていくと、同じ形が山ほどありました。
岡山城を ↔ 岡山城で    助詞が違うだけ
終了し   ↔ 終了い      終了した / 終了いたしました
月1日   ↔ 月10      「10月10日」の数字を途中で切っている
誤植候補は1,301件。 せっかく精度を上げたつもりだったのに、実際の現場ではまだこの状態でした。
なぜまた出たのか(自分で開けた穴だった)
原因を追うと、これは自分で開けた穴でした。
「ライバ」を直したとき、「同じ文字種の連続を途中で切らない」というルールを入れました。ところがこれを厳密に適用すると、送り仮名の揺れが検出できなくなることが後で分かったのです。
お問い合わせフォーム  → 検出できる
お問い合わせはこちら  → 候補ごと消える  ← 日本語で一番多い形
日本語は「語+助詞」の形が圧倒的に多いので、語尾のひらがなで切るのを一律に禁止すると、「お問い合わせ/お問合せ」のような本物の表記揺れが原理的に拾えなくなります。
そこで語尾のひらがなだけルールを緩めたのですが、その緩めた隙間から「岡山お」が入ってきたわけです。片方を立てれば片方が崩れる、という典型的なトレードオフでした。
気づいたこと:本物の誤植は語の「内側」で起きる
しばらく悩んで、共通点に気づきました。
誤検知はどれも差分が語の端にあります。そして片方がひらがなか数字です。
一方、本物の誤植はどうか。
カード ↔ 力ード          「カ」が「力」に化けている(語の中)
マタニティー ↔ マタニティ-  長音符がハイフンに(語の中)
工具の使い方 ↔ 工具の扱い方  語の内側
本物は語の内側で起きています。 端の1文字だけが違うのは、たいてい「どこで切ったか」がズレているだけなのです。
そこで「差分が先頭か末尾にあって、片方がひらがなか数字なら候補にしない」という条件を入れました。ひらがなを一律に禁止するのではなく、端に限定したのがポイントです。これなら「お問い合わせ」は語の内側で判定されるので生き残ります。
結果、誤植候補は 1,301件 → 12件になりました。
残った12件は、直せない種類のもの
残ったものを見ると、性質が違いました。
岡山城 ↔ 岡山市     どちらも実在する地名
備前焼 ↔ 備前刀     どちらも実在する語
ナイト ↔ ナイフ     どちらも実在する語
これは閾値をどういじっても分離できません。「岡山市は実在する地名だ」と知るには辞書が必要で、持っていないからです。
なので、機械的に落とせるもの(語境界のズレ)と、原理的に落とせないもの(どちらも実在する語)を、はっきり分けて扱うことにしました。前者は完全に除去し、後者は確信度を上げずに「時間があれば見る候補」として残す。12件なら目を通せます。
学び:トレードオフは一度で終わらない
この件で一番の学びは、「一つのルールで両方をまかなおうとして失敗した」ことでした。
「語尾のひらがなで切るのは禁止」と決めたら送り仮名が死に、「語尾は許す」と決めたら断片が復活する。どちらも正しくない。条件をもう一段細かくして「端に限定する」としたら、初めて両立しました。
そしてもう一つ。この誤検知に気づいたのは、テストではなく実際のレポートを眺めていたときでした。テストは自分が想定した範囲しか守ってくれません。「岡山おもてなし武将隊」という固有名詞は、私の想定になかったものです。
作り終えたと思ってからが本番、という当たり前の話でした。